二者是同一个模型:Fable 5.2 在网络安全和生物学方面配备了强化的安全防护措施,面向所有人开放;Mythos 5.2 则仅通过其网络安全和生命科学验证计划,或面向企业的 Claude Security,提供给经过验证的机构。
其价格为每百万输入 token 8 美元、每百万输出 token 40 美元,并提供可选的快速模式(速度最高提升 2.5 倍),价格为标准的两倍。该模型已在 AWS、Google Cloud 和 Microsoft Azure 上线。
Anthropic 表示,其主代码库中合并的变更已有超过 90% 由 Claude 编写,并且 1,000 个 Fable 5.2 智能体在约 30 小时内用 Lean 完成了费马大定理的形式化。Fable 5.2 拦截的查询比 5.1 少 55%,公司还有意将其 AI 研发能力保持在 Opus 5.5 水平左右。英国 AI Security Institute 和 METR 等机构对其进行了评估。
Claude Fable 5.2 和 Claude Mythos 5.2 在编码、推理和视觉等领域均有提升。在发布前的测试中,它们帮助我们的工程师完成了原本无法实现的软件迁移,从零设计了三款可运行的电子设备,解决了黑洞物理学中的两个未解问题,在机器人评估中取得了实质性进展,并在 30 小时内完成了费马大定理证明的形式化,此外还有许多其他应用,我们将在下文详述。
Claude Fable 和 Claude Mythos 共享同一底层模型。Fable 配备了强有力的网络安全和生物防护措施以防止滥用,这使我们能够向所有用户开放。寻求在网络安全或生物医学研究领域进行有益应用的机构,可以通过我们近期扩大的生命科学和网络验证计划申请使用 Mythos。
测试人员发现,Fable 5.2 和 Mythos 5.2 的表达比此前的 Fable 和 Mythos 模型更加清晰。它们生成结果的速度比 Claude Fable 5.1 和 Claude Mythos 5.1 最多快 30%,且价格更低:每百万输入 token 8 美元,每百万输出 token 40 美元。
Fable 5.2 和 Mythos 5.2 还提供可选的快速模式,可将 token 生成速度最多提升 2.5 倍。快速模式的价格为每百万输入 token 16 美元、每百万输出 token 80 美元。
安全与对齐。为确保安全与对齐能够跟上模型日益增强的能力,我们在发布前对支撑 Fable 5.2 和 Mythos 5.2 的模型进行了大量安全测试。其中包括开发新的评估方法,以更深入地洞察特定的令人担忧的行为,例如沙箱逃逸。我们认为,由未对齐带来的高影响风险仍然较低,且该模型在大多数对齐指标上的表现与我们近期的模型持平或更优。Fable 5.2 的网络和生物安全防护与 Fable 5.1 同样稳健,但不必要的拦截更少,我们还部署了迄今为止最强的防蒸馏攻击保护措施。
下文将更详细地介绍我们的安全测试,完整信息请参阅Claude Fable 5.2 和 Mythos 5.2 系统卡。
何时使用 Claude Fable 5.2 和 Mythos 5.2。Fable 和 Mythos 最适合最具雄心的开放式技术工作。对于大多数编码和知识管理任务,我们建议用户先使用我们的日常主力工具 Claude Opus 5.5,然后根据工作范围和复杂程度按需切换至其他模型:Fable 或 Mythos,或 Claude Sonnet 5.5、Claude Haiku 5.5。Fable 5.2 还可以作为顾问(由 Haiku、Sonnet 或 Opus 模型向其咨询,以帮助解决更复杂的问题)或编排者(将较简单的任务分派给较小的模型)使用。
Claude Fable 5.2 和 Mythos 5.2 评估
基准性能。下方基准表显示,在我们评估的几乎所有能力上,Claude Fable 5.2 和 Mythos 5.2 都比 Opus 5.5 更胜一筹:
| Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon | |
|---|---|---|---|---|---|
| 智能体编码FrontierCode 2.0 | 49.1%超高努力 | 32.4%超高努力 | 45.5% | 42.8% | 41.1%中等努力 |
| 智能体编码FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| 企业工作流AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| 智能体科学研究Terminal-Bench Science 0.1 | 74.6%75.3%(Mythos 5.2) | 52.6% | 58.7% | 68.1% | 64.8% |
| 网络安全CyScenarioBench † | 76.3%Mythos 5.2 | 61.7%Mythos 5.1 | 67.6%无安全防护 | 61%GPT-6 Cyber | — |
| 网络安全CVE 重新发现 | 89.6%Mythos 5.2 | 78.3%Mythos 5.1 | 81.3%无安全防护 | — | — |
| 蛋白质设计从头结合剂设计(24 小时) | 85.1%Mythos 5.2 | 79.1%Mythos 5.1 | 82.6%无安全防护 | — | — |
| 智能体搜索WANDR(宽松评分) | 82.1% | 68.7% | 72.3% | — | — |
| 计算机使用OSWorld 2.1(离线集,部分) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| 机器人RoboDojo Sim ‡ | 64.9% | 27.6% | 39.4% | 29.8% | — |
| 知识工作AA Briefcase v1.1 | 66.1%评分标准 | 61.5%评分标准 | 61.2%评分标准 | 52.0%评分标准 | 61.8%评分标准 |
| 1785Elo | 1669Elo | 1800Elo | 1569Elo | 1611Elo | |
| 知识工作远程劳动指数(RLI) | 41.3%高努力 | 17.9% | 21.3% | 20.8% | — |
| 多学科推理人类最后的考试(使用工具) | 74.2% | 65.6% | 67.7% | 57.2% | — |
| 视觉图表识别Cartography(不使用工具) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
有关评估方法的详细信息,请参阅Claude Fable 5.2 和 Claude Mythos 5.2 系统卡。除非另有说明,Fable 5.2、Fable 5.1 和 Opus 5.5 的分数均为启用安全防护措施时的结果。除非另有说明,所有分数均为各模型可用的最高努力级别下的结果。† 在 CyScenarioBench 中,各实验室的分数基于单次任务。‡ RoboDojo Sim 显示的是可用的最高努力级别,且为内部运行。
努力级别与效率。在中等努力级别(Claude 和 Claude Code 应用的默认设置)下,Fable 5.2 能以比 Fable 5.1 更少的 token 完成复杂任务。在 FrontierCode 2.0 评估的早期测试中,高努力级别下的 Fable 5.2 得分与最高努力级别下的 Opus 5.5 相近,而每项任务成本约为其一半。在超高努力级别下,它还取得了所有受测已发布模型中的最高分。
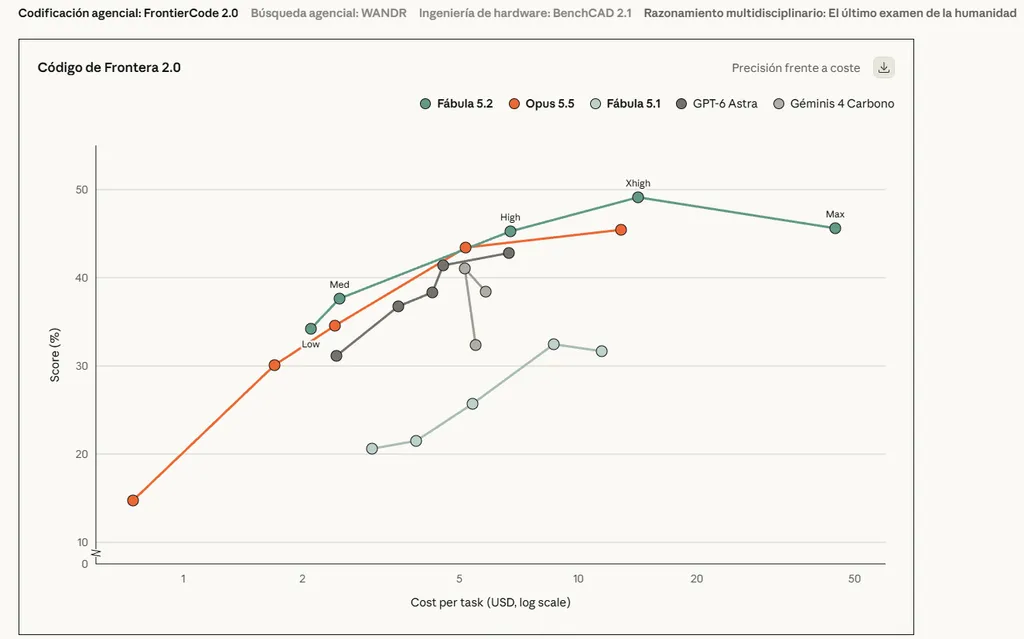
FrontierCode 衡量的是开源代码库维护者是否会合并某个模型提交的代码变更。在高努力级别下,Fable 5.2 的得分与 Opus 5.5 的最佳成绩相近(45.3% 对 45.5%),而每项任务成本约为其一半,并以相近的成本超越了 GPT-6 Astra 的最佳成绩(42.8%)。在超高努力级别下,Fable 5.2 达到 49.1%,是我们测试过的所有已发布模型中的最高分。
编码
目前,Anthropic 代码库中合并的变更有超过 90% 出自 Claude 之手(在人工监督下)。我们已使用 Fable 5.2 在几分钟内修复了长期存在的错误,优化了所有服务的性能,并完成了原本过于耗时或成本过高的高价值软件项目。一个使用 Fable 5.2 早期版本的智能体团队将一项关键生产服务从 Python 迁移到了 Rust;如今该服务更加高效、可靠,启动速度提升约 26 倍。我们发现,Fable 5.2 展现出扎实的工程判断力,即使面对模糊的请求也能产出高质量的结果。
作为一项实验,一名 Anthropic 工程师让 Fable 5.2 设计一个操作系统原型。该模型从一个空文件夹起步,协调了 1,000 多个子智能体,连续八天不间断地编写、测试和审查代码。最终成果是一个可在笔记本电脑上启动的可运行操作系统,拥有用于系统运行的自有内核、磁盘、键盘和网络驱动程序、持久化文件存储、窗口、登录界面、安装程序以及内置的 Claude 功能(见下方视频)。
每周精选,直达您的邮箱
每周一:Territorio Blockchain 阅读量最高的新闻、最新一期播客以及我们活动的最新消息。免费,无垃圾邮件。
我们会发送一封确认邮件。您可以随时通过每期简报中的链接退订。 隐私政策