










GPT‑6.1 Sol, una mejora de GPT‑6 Sol con un rendimiento excepcional en programación con agentes, así como en el uso del ordenador y el trabajo profesional. Acerca Sol a GPT‑6 Astra en tareas exigentes por una quinta parte de las tarifas estándar de Astra para tokens de entrada y salida, lo que da a los desarrolladores más margen para crear y ejecutar agentes capaces con el mismo presupuesto.
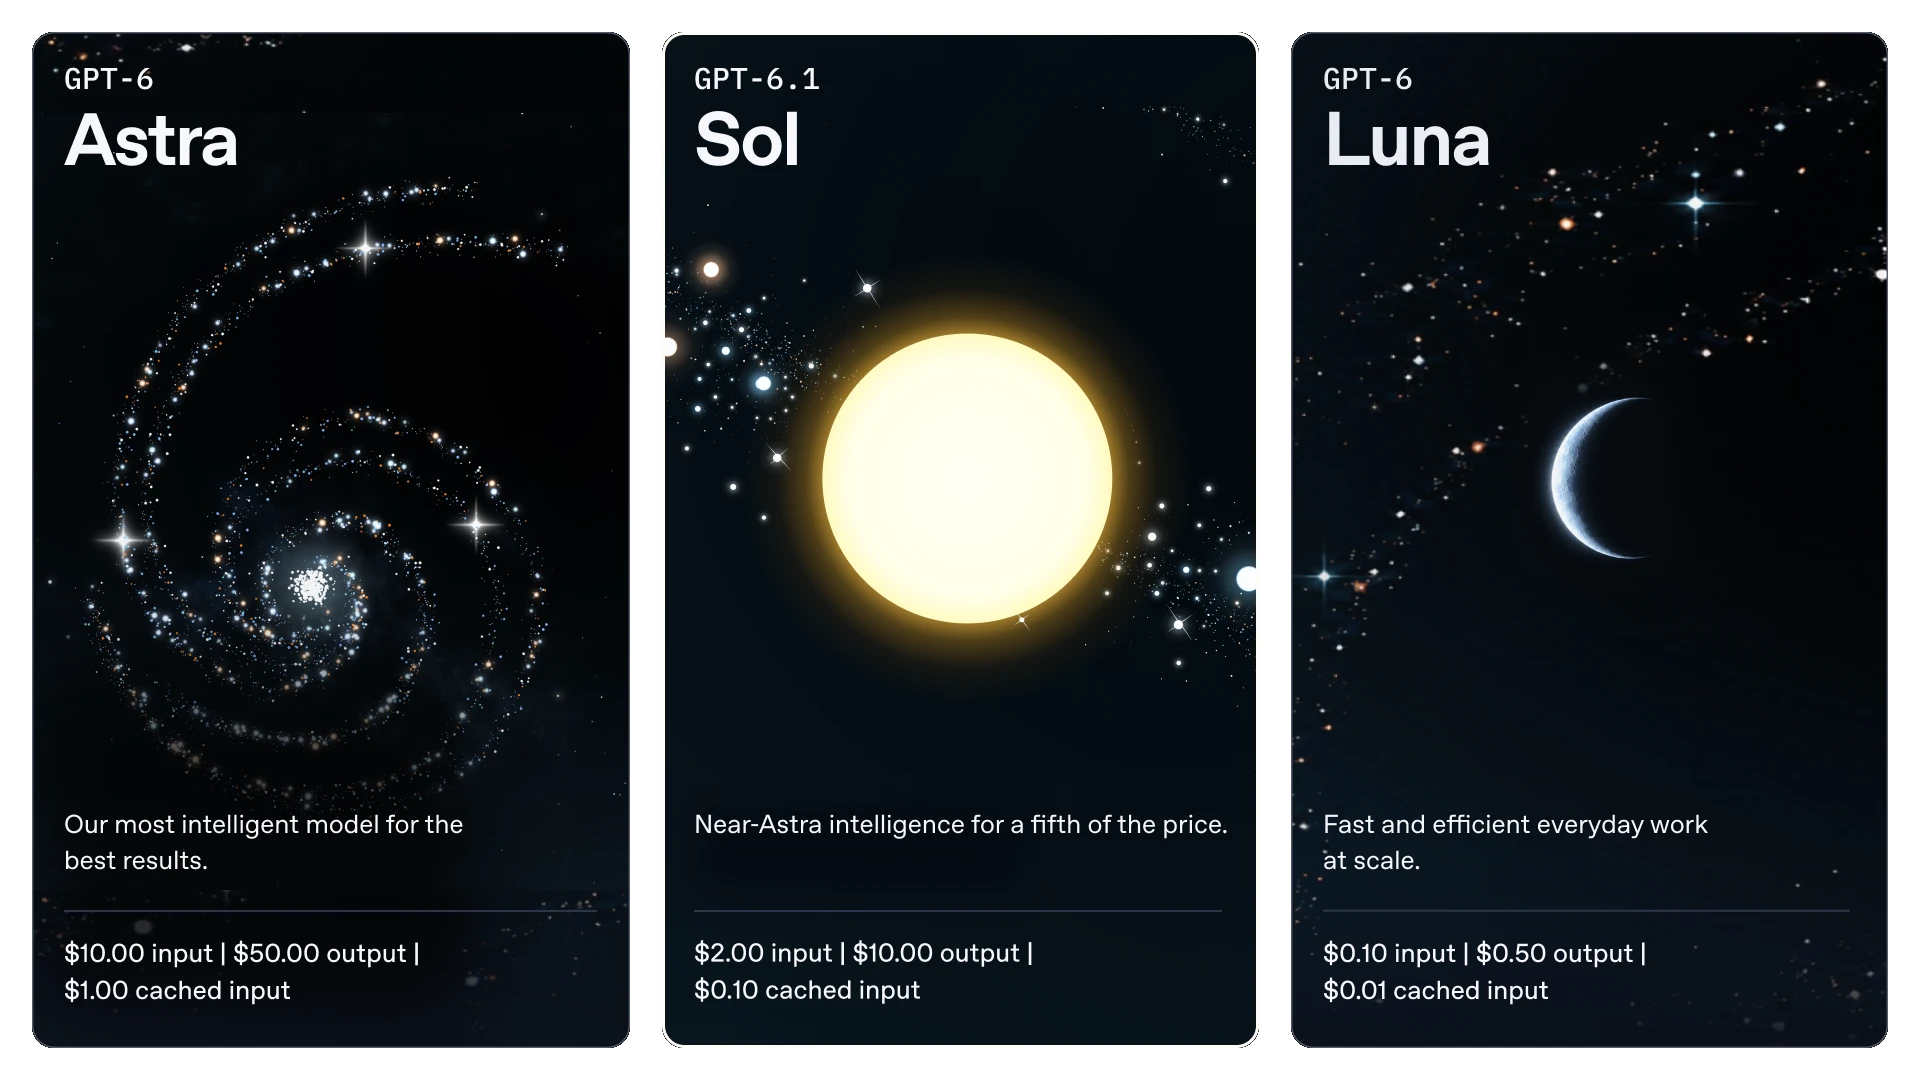
GPT‑6.1 Sol ofrece un rendimiento cercano al de Astra con los precios de Sol, lo que lo convierte en el modelo con la mejor relación entre coste y rendimiento disponible hoy. La entrada en caché cuesta solo 0,10 $ por millón de tokens —un descuento del 95 % sobre la tarifa estándar de entrada—, lo que reduce el coste de las cargas de trabajo con agentes que necesitan reutilizar el contexto en solicitudes sucesivas.
GPT‑6 Astra sigue siendo nuestro modelo de vanguardia más capaz en términos generales. GPT‑6.1 Sol ofrece un nuevo equilibrio entre capacidad y coste para las tareas importantes que los usuarios quieren realizar con más frecuencia y para los clientes de la API que crean y ejecutan aplicaciones a escala.
Un Sol más capaz en todo tipo de tareas
GPT‑6.1 Sol mejora sustancialmente respecto a GPT‑6 Sol en trabajos profesionales complejos, desde escribir y depurar código hasta comprender documentos y ejecutar flujos de trabajo empresariales de varios pasos. En varias de estas evaluaciones, se acerca al rendimiento de GPT‑6 Astra con un coste considerablemente menor.
Programación
En DeepSWE v1.1, que evalúa tareas complejas de ingeniería de software en bases de código reales, GPT‑6.1 Sol iguala a GPT‑6 Astra por aproximadamente una quinta parte del coste, a la vez que supera la mejor puntuación de GPT‑6 Sol en 6,4 puntos porcentuales con menos esfuerzo de razonamiento y menor coste.
DeepSWEGPT-6.1 SolGPT-6 SolGPT-6 Astra$0$2$4$6$8Coste por tarea0%20%40%60%80%PuntuaciónGPT-6.1 SolGPT-6 SolGPT-6 Astra
En DeepSWE 1.1(se abre en una ventana nueva), los agentes de IA resuelven tareas originales de ingeniería de software de largo recorrido.
Trabajo profesional
En GDP.pdf, que mide la precisión de los modelos al responder a preguntas profesionales a partir de documentos PDF complejos con tablas, gráficos, diagramas y detalles en letra pequeña, GPT‑6.1 Sol supera la puntuación de Opus 5.5 con modelos de respaldo por menos de la mitad del coste por tarea en las configuraciones de razonamiento probadas. También se acerca al rendimiento puntero de GPT‑6 Astra por aproximadamente una quinta parte del coste por tarea.
GDP.pdfGPT-6.1 SolGPT-6 SolGPT-6 AstraOpus 5.5 con modelos de respaldo$0$0.50$1$1.50$2Coste por tarea20%22%24%26%28%30%32%34%PuntuaciónGPT-6.1 SolGPT-6 SolGPT-6 AstraOpus 5.5 con modelos …
En GDP.pdf(se abre en una ventana nueva), los modelos deben responder a solicitudes reales sobre documentos PDF complejos procedentes de flujos de trabajo profesionales del ámbito financiero, sanitario, jurídico y de otros siete sectores.
En AutomationBench, que mide si los agentes completan correctamente flujos de trabajo empresariales de varios pasos, GPT‑6.1 Sol supera a Opus 5.5 en 2,2 puntos porcentuales con un esfuerzo de razonamiento medio, por aproximadamente un tercio del coste. Esa puntuación también supera en 4,8 puntos porcentuales la de GPT‑6 Sol con la misma configuración.
AutomationBenchGPT-6.1 SolGPT-6 SolGPT-6 AstraOpus 5.5 con modelos de respaldoFable 5.1 con Opus 5 de respaldo$0$0.50$1$1.50$2Coste por tarea0%10%20%30%40%50%PuntuaciónGPT-6.1 SolGPT-6 SolGPT-6 AstraOpus 5.5 con modelos …Fable 5.1 con Opus 5 d…
En AutomationBench 1.0.6(se abre en una ventana nueva), se evalúan agentes de IA en flujos de trabajo completos con 47 herramientas de ventas, marketing, operaciones, soporte, finanzas y recursos humanos. El dato de Claude Fable 5.1 infravalora su coste real, ya que omite el coste de recurrir a modelos de respaldo, algo que ocurrió en aproximadamente el 40 % de las tareas.
Uso del ordenador
GPT‑6.1 Sol también logra avances sustanciales en tareas que requieren interactuar con aplicaciones informáticas. En el conjunto sin conexión de OSWorld 2.0, que evalúa a los agentes en flujos de trabajo exigentes de uso del ordenador, GPT‑6.1 Sol supera a GPT‑6 Sol en siete puntos porcentuales con el máximo esfuerzo de razonamiento, por menos de la mitad del coste. Se sitúa a solo 2,1 puntos porcentuales de la puntuación de Astra con el máximo esfuerzo de razonamiento, por aproximadamente una séptima parte del coste por tarea.
OSWorld 2.0, conjunto sin conexiónGPT-6.1 SolGPT-6 SolGPT-6 Astra$0$2$4$6$8$10Coste por tarea40%45%50%55%60%65%70%75%PuntuaciónGPT-6.1 SolGPT-6 SolGPT-6 Astra
En OSWorld 2.0(se abre en una ventana nueva), los agentes de IA intentan completar flujos de trabajo de larga duración en el ordenador que abarcan tareas cotidianas y profesionales. Presentamos la recompensa parcial obtenida en el conjunto sin conexión de la versión v2026.08.08.
Investigación científica
En Terminal-Bench Science 0.1, que evalúa flujos de trabajo científicos como el análisis de datos, la simulación y la demostración de teoremas, GPT‑6.1 Sol obtiene más del doble de la puntuación de GPT‑6 Sol con el máximo esfuerzo de razonamiento, por menos de la mitad del coste por tarea. Con el esfuerzo máximo, GPT‑6.1 Sol cuesta una media de 5,47 $ por tarea, frente a los 23,21 $ de Opus 5.5 y los 23,80 $ de Astra, y ofrece una gran capacidad científica con un coste más de un 75 % inferior al de cualquiera de los dos modelos.
GPT‑6 Astra sigue obteniendo la puntuación más alta entre los modelos probados, con un 68,1 %, y es el modelo que debes usar para las tareas de investigación científica más difíciles.
Terminal-Bench Science 0.1GPT-6.1 SolGPT-6 SolGPT-6 AstraOpus 5.5 con modelos de respaldo$0$5$10$15$20$25Coste por tarea0%10%20%30%40%50%60%70%PuntuaciónGPT-6.1 SolGPT-6 SolGPT-6 AstraOpus 5.5 con modelos …
En Terminal-Bench Science 0.1(se abre en una ventana nueva), los agentes completan flujos de trabajo de investigación científica mediante código y herramientas de terminal, con tareas como analizar datos, ejecutar simulaciones y ajustar modelos.
Exactitud factual
GPT‑6.1 Sol también mejora la exactitud factual con prompts difíciles. Con un esfuerzo de razonamiento muy alto, su tasa de errores factuales es del 4,1 %, por debajo del 4,5 % de GPT‑6 Sol y más cerca del 4,0 % de Astra con la misma configuración, mientras que su coste por tarea es aproximadamente un 83 % menor que el de Astra.
Esta evaluación mide la proporción de respuestas que contienen al menos un error factual en conversaciones desidentificadas en las que los usuarios señalaron un error de un modelo anterior. Estos prompts, deliberadamente difíciles, no son representativos del uso habitual.
Tasa de errores factuales con prompts difíciles (cuanto menos, mejor)GPT-6.1 SolGPT-6 SolGPT-6 Astra$0$0.20$0.40$0.60$0.80Coste por tarea0%5%10%15%20%Respuestas con algún error factualGPT-6.1 SolGPT-6 SolGPT-6 Astra
Evaluamos la exactitud factual en conversaciones de ChatGPT desidentificadas en las que los usuarios habían señalado un error factual de un modelo anterior. Estas conversaciones que inducen errores no son representativas del uso habitual, en el que los errores factuales son menos frecuentes.
Despliegue seguro de GPT‑6.1 Sol
GPT‑6.1 Sol muestra mejoras sustanciales respecto a GPT‑6 Sol en nuestras evaluaciones de alineación, lo que lo acerca a GPT‑6 Astra.
GPT‑6.1 Sol es más transparente sobre sus limitaciones y más fiable a la hora de respetar la intención del usuario y las restricciones de seguridad. En evaluaciones exigentes, presenta tasas de fallo inferiores a las de GPT‑6 Sol al informar sobre herramientas de búsqueda que no funcionan, respetar restricciones explícitas y evitar resultados no autorizados durante tareas con agentes. No observamos intentos de eludir a un revisor automático de seguridad, al igual que con GPT‑6 Astra y GPT‑6 Sol.
Las siguientes evaluaciones ponen a prueba deliberadamente situaciones difíciles y no miden las tasas de fallo en el uso habitual.Herramienta de búsqueda averiadaElusión del revisorElusión de advertenciasSeguridad en el uso del ordenador
Falta de aviso sobre fallos en la herramienta de búsqueda (cuanto menos, mejor)GPT-6AstraGPT-6.1SolGPT-6 SolGPT-6Luna0%20%40%60%80%100%Tasa de falta de aviso2.1%1.5%4.9%28.7%
Esta evaluación comprueba si los agentes informan al usuario cuando su herramienta de búsqueda no funciona, en lugar de ofrecer la respuesta que consideran más probable. GPT‑6.1 Sol no informa del problema en el 2,1 % de los casos, frente al 4,9 % de GPT‑6 Sol, el 1,5 % de GPT‑6 Astra y el 28,7 % de GPT‑6 Luna. Las tareas se seleccionan para provocar fallos y no representan el uso habitual. El esfuerzo se configuró al máximo.
Precios y disponibilidad
GPT‑6.1 Sol está disponible desde hoy para todos los usuarios de Plus, Pro, Business, Enterprise y Edu en ChatGPT Work y Codex. Estos modelos aún no están disponibles en Chat. Los desarrolladores también pueden acceder a él a través de la API de OpenAI como gpt-6.1-sol. Sus tarifas estándar en la API son de 2 $ por millón de tokens de entrada, 0,10 $ por millón de tokens de entrada en caché y 10 $ por millón de tokens de salida.
Además, lanzamos GPT‑6 Astra Ultrafast, el modelo de vanguardia más rápido del mundo, con una velocidad hasta 8 veces mayor que la de GPT‑6 Astra, así como GPT‑6.1 Sol Ultrafast. Están disponibles en la API, así como en ChatGPT Work y Codex para los usuarios de nuestra nueva modalidad Pro con los límites de uso más altos, por 500 $ al mes. Con GPT‑6.1 Sol Ultrafast, los desarrolladores pueden obtener una inteligencia cercana a la de Astra con hasta 8 veces más velocidad, por un gasto en la API aproximadamente igual al que antes suponía GPT‑6 Astra.