在 Gemini 4 Argon 发布两周后,Gemini 4 Carbon 正式登场,Google 称其为旗下最强大的模型。据 Google 介绍,该模型在 Artificial Analysis 指数中位居榜首,并在一项间接提示注入测试中实现了 0% 的攻击成功率。Google 还表示,其内部智能体已连续数天执行多步骤任务。
该模型将分阶段推出:首先面向一批网络安全防御者,随后扩展至可信合作伙伴,并事先接受美国政府的测试。发布价格为每百万输入/输出 token 2 美元/10 美元,之后将上调至 4 美元/20 美元。
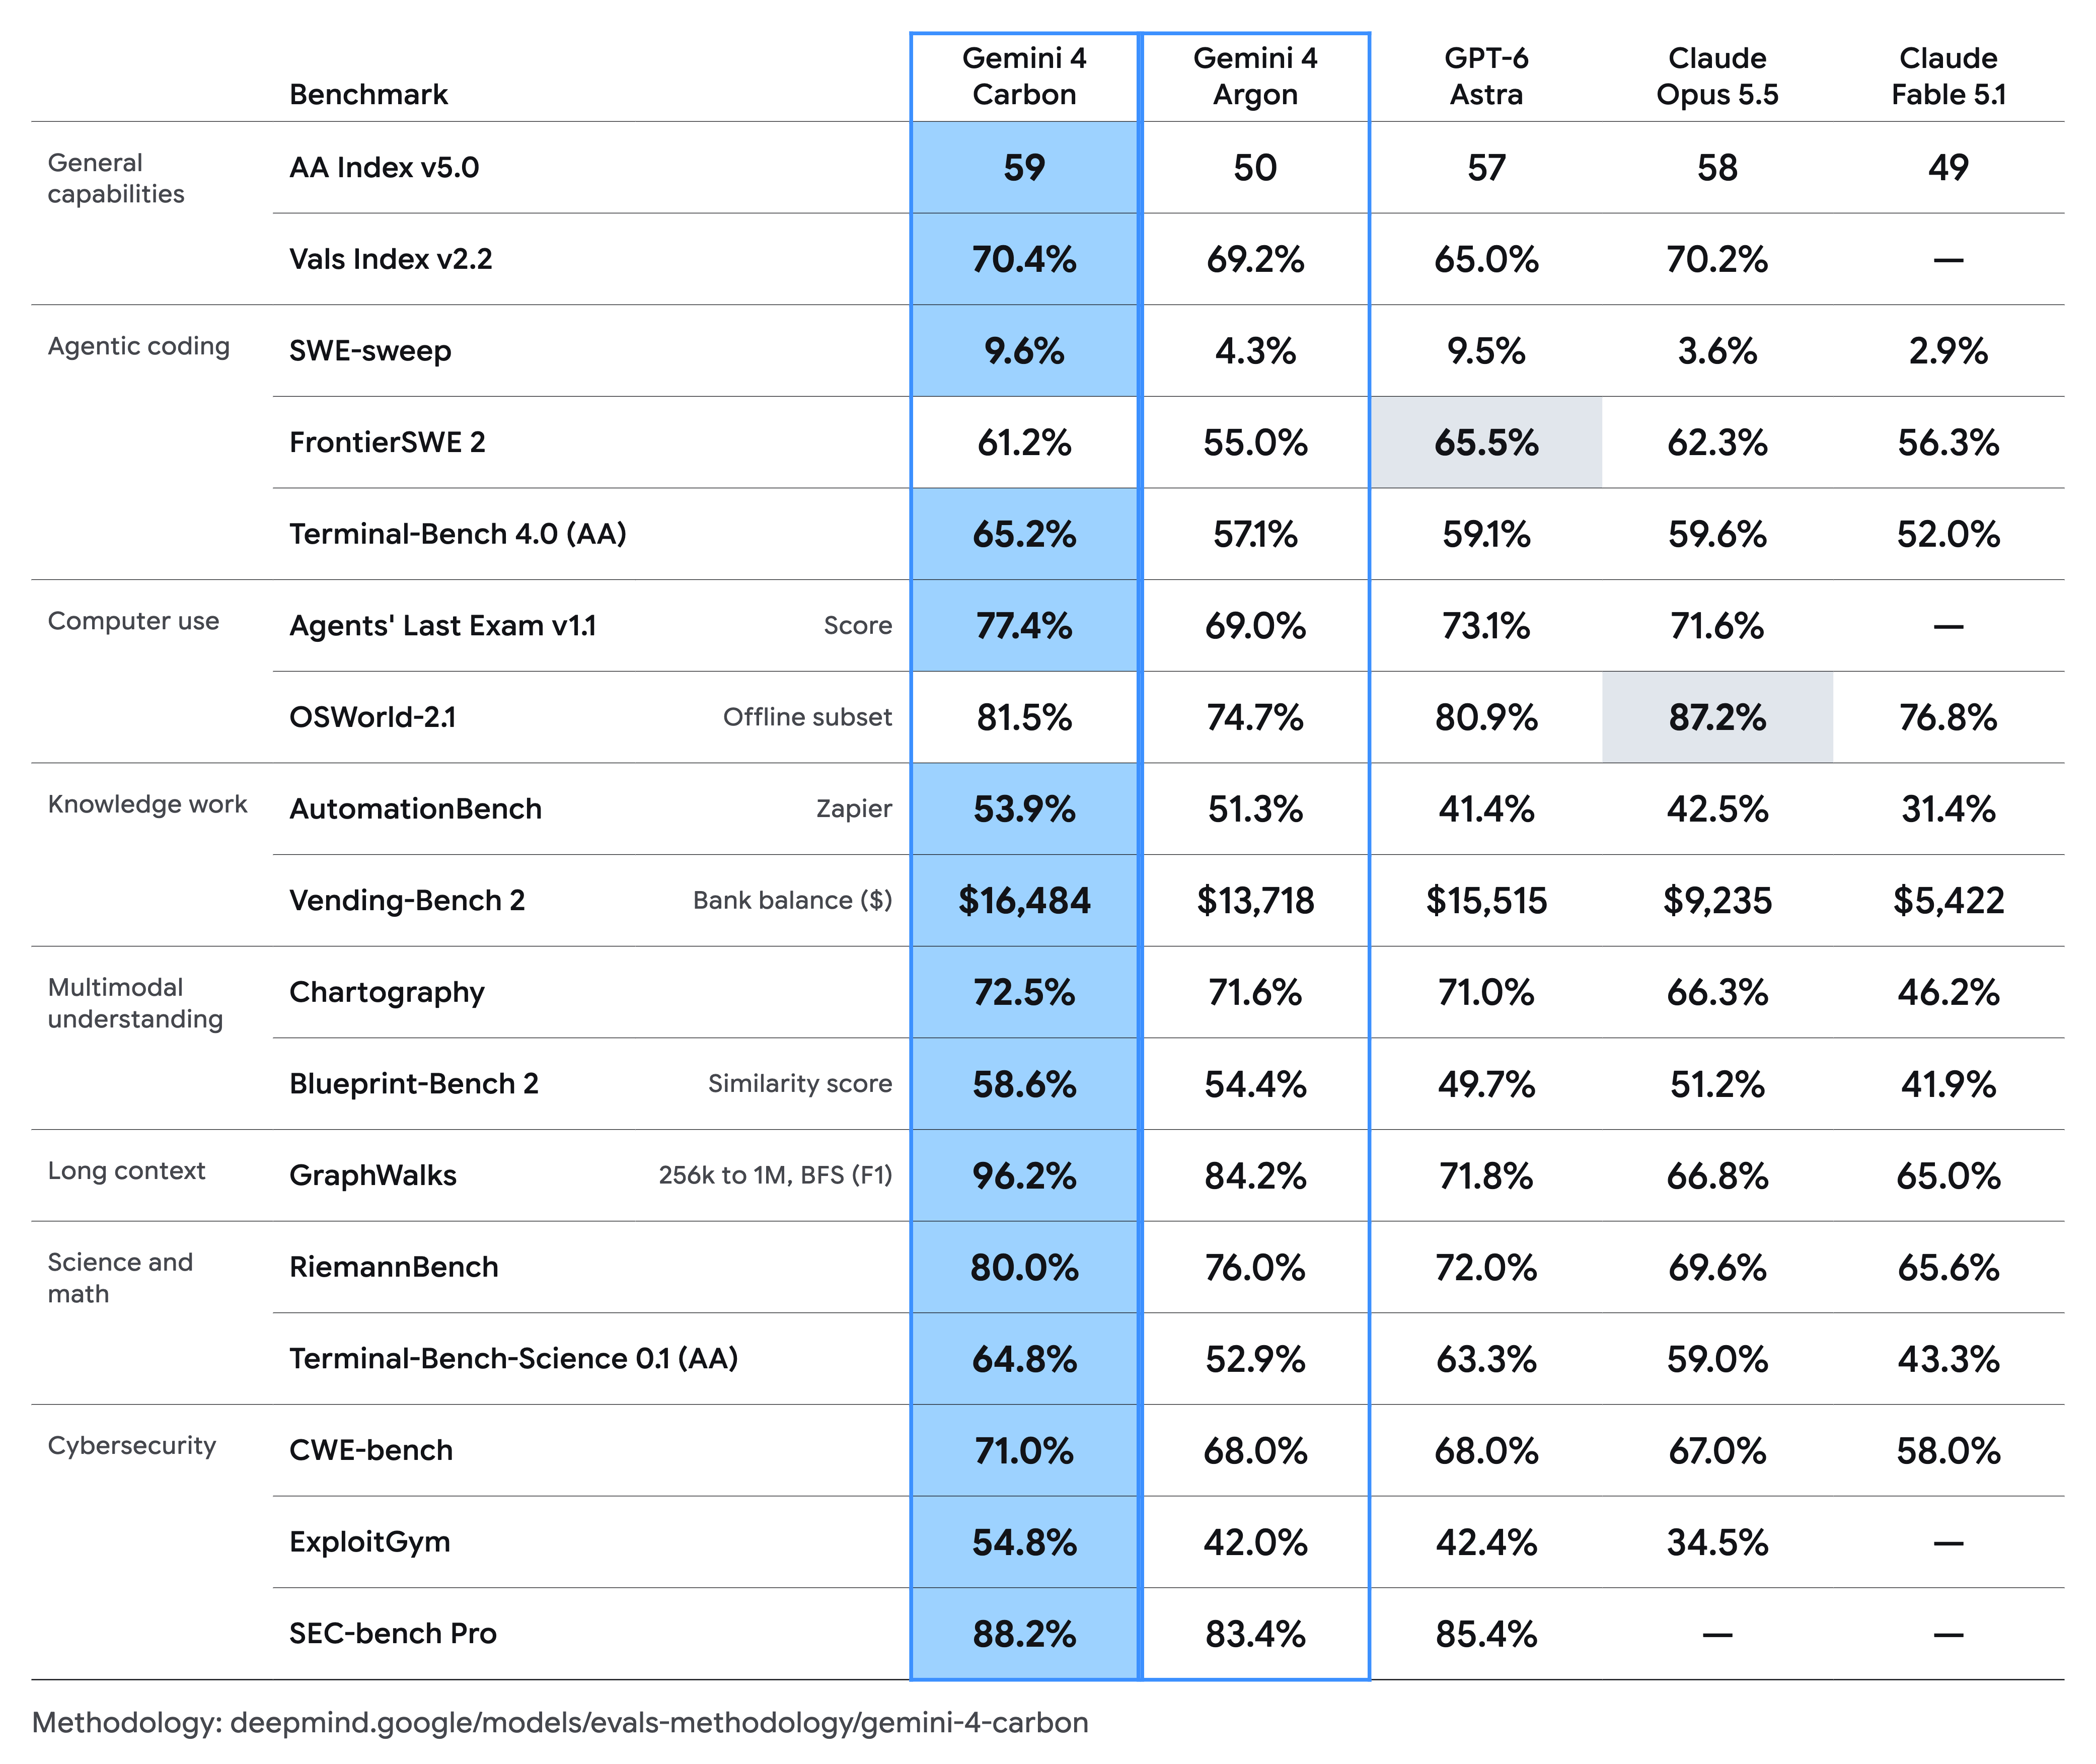
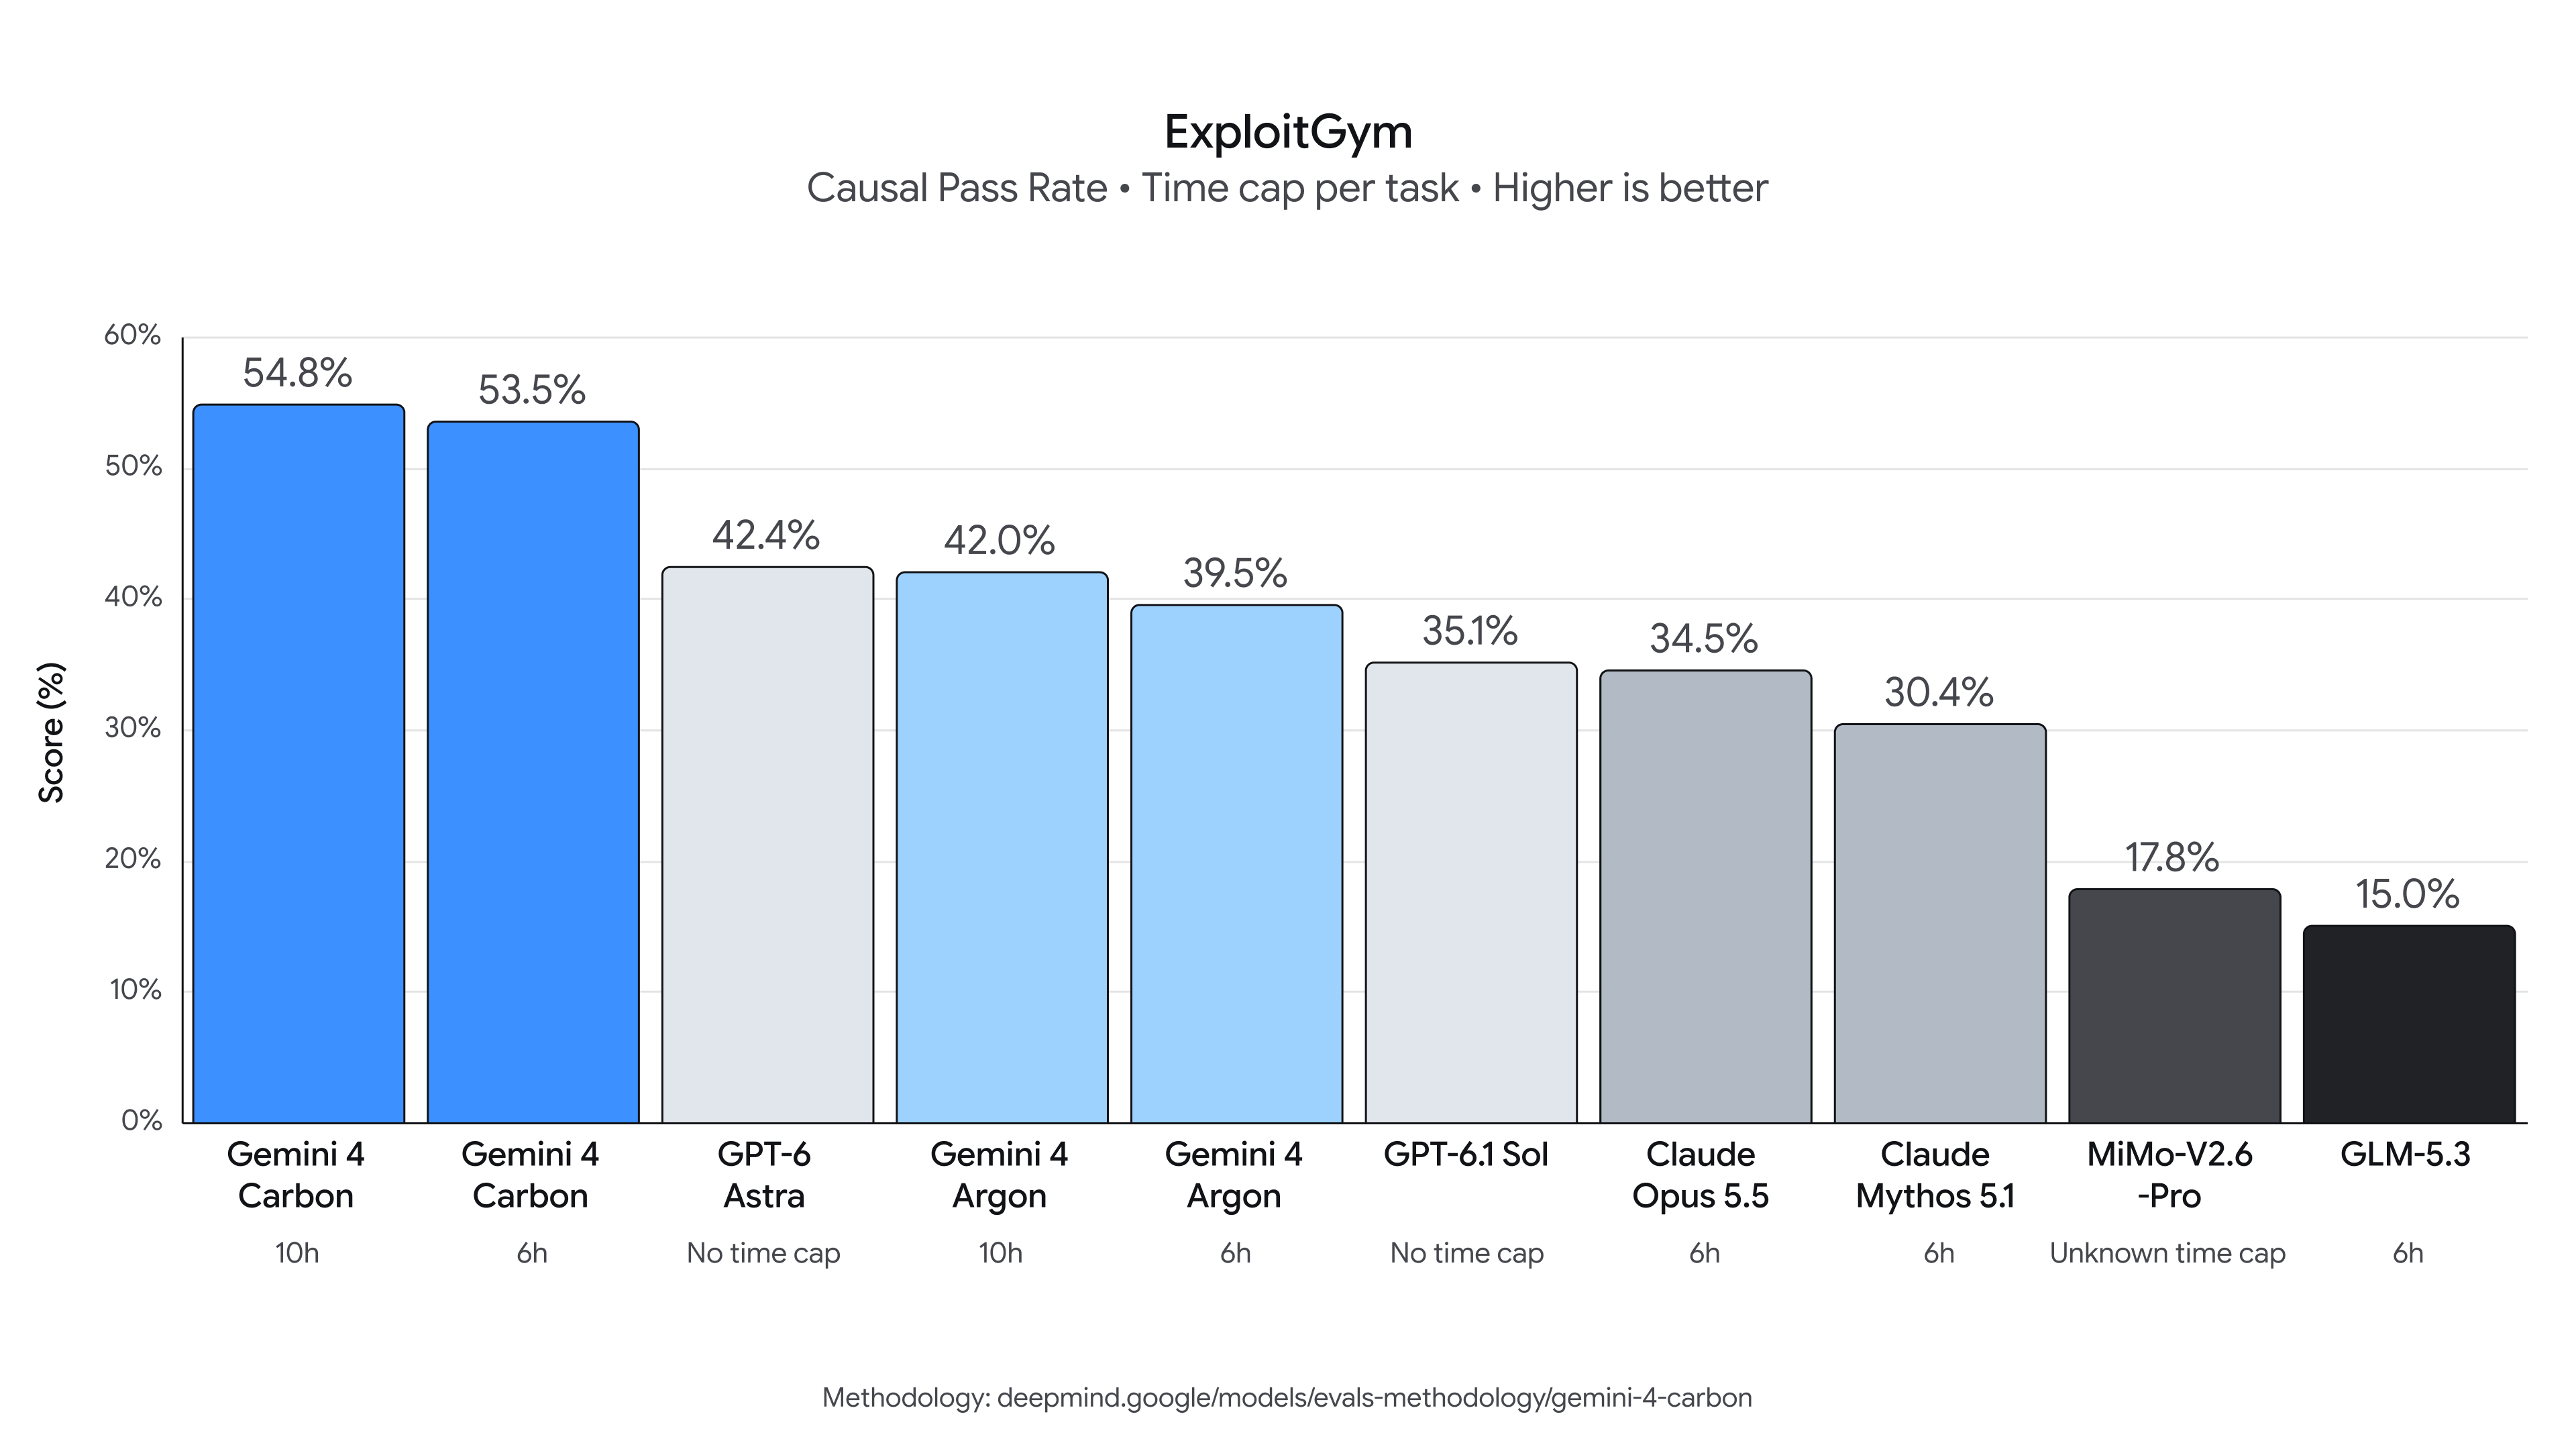
Carbon 在近期更新的 5.0 版 Artificial Analysis 智能指数中排名第一 ,得分为 59。该模型在编程和智能体任务,以及网络安全防御的关键能力方面均取得显著进步,在漏洞检测基准 SEC-bench Pro(88.2%)、漏洞利用基准 ExploitGym(54.8%)和补丁修复基准 CWE-bench(71.0%)上稳居领先地位。在内部测试中,Carbon 大幅提升了安全代码的生成能力;在与我们自有团队合作的实时编程环境中,其错误率和造假率均有所降低。
Carbon 以两周前发布的 Gemini 4 Argon 为基础 ,展现了我们拓展科学前沿的惊人速度。我们的研究人员与模型并肩协作,加速能力开发,同时不断强化安全措施。
我们在发布上采取审慎细致的方式,并积极参与美国政府针对模型发布前测试的自愿性流程。从本周起,我们将向部分网络安全专家开放 Carbon,并通过我们的 Fairwind 计划逐步将访问权限扩展至其他可信合作伙伴 。在 Carbon 尽快通过我们的产品平台向开发者、企业和消费者开放之前,我们将继续收集反馈并完善安全措施。
Gemini 4 Carbon 将以与 Argon 相同的推广价格发布 1:每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 在输入 token 价格基础上享受 95% 的折扣。
提升编程与推理能力,应对高难度长周期任务
Carbon 专为处理更为复杂、周期更长的工程问题而设计,面向持续运行的自动化工作流。在内部,我们的团队已看到 Carbon 连续运行数天,克服障碍并处理复杂的多阶段工程任务,例如在大型代码库和底层系统中定位根本原因并修复细微错误。
基于用户反馈,我们着力提升模型在多个领域的表现,包括编程、自动化任务和科学任务,以及全栈 Web 开发和多模态理解。得益于 Web 开发中结果和产物质量的提升,Carbon 的 Elo 评分上升 89 分,在 WebDev Arena 中位列第 4 名(1768)。
前沿网络安全性能,助力构建安全系统
Gemini 4 Carbon 在网络安全能力上实现了质的飞跃。它在网络防御的整个生命周期——漏洞检测、验证和修复——均达到了前沿水平。
我们的团队已在网络防御方面看到重大进展。在内部测试中,Carbon 生成安全代码的成功率是 Argon 的两倍以上。再举一例,Chrome 团队报告称,在生成高质量补丁方面,Carbon 的表现比另一家实验室的前沿模型高出 10 倍以上。我们领先的云安全平台 Wiz 也观察到,Carbon 在 Web 渗透测试中处于领先地位,而这正是 Wiz 的 Scan for Good 计划的一项核心能力 。
Carbon 在主要外部基准测试中表现突出(无限制条件下评估):
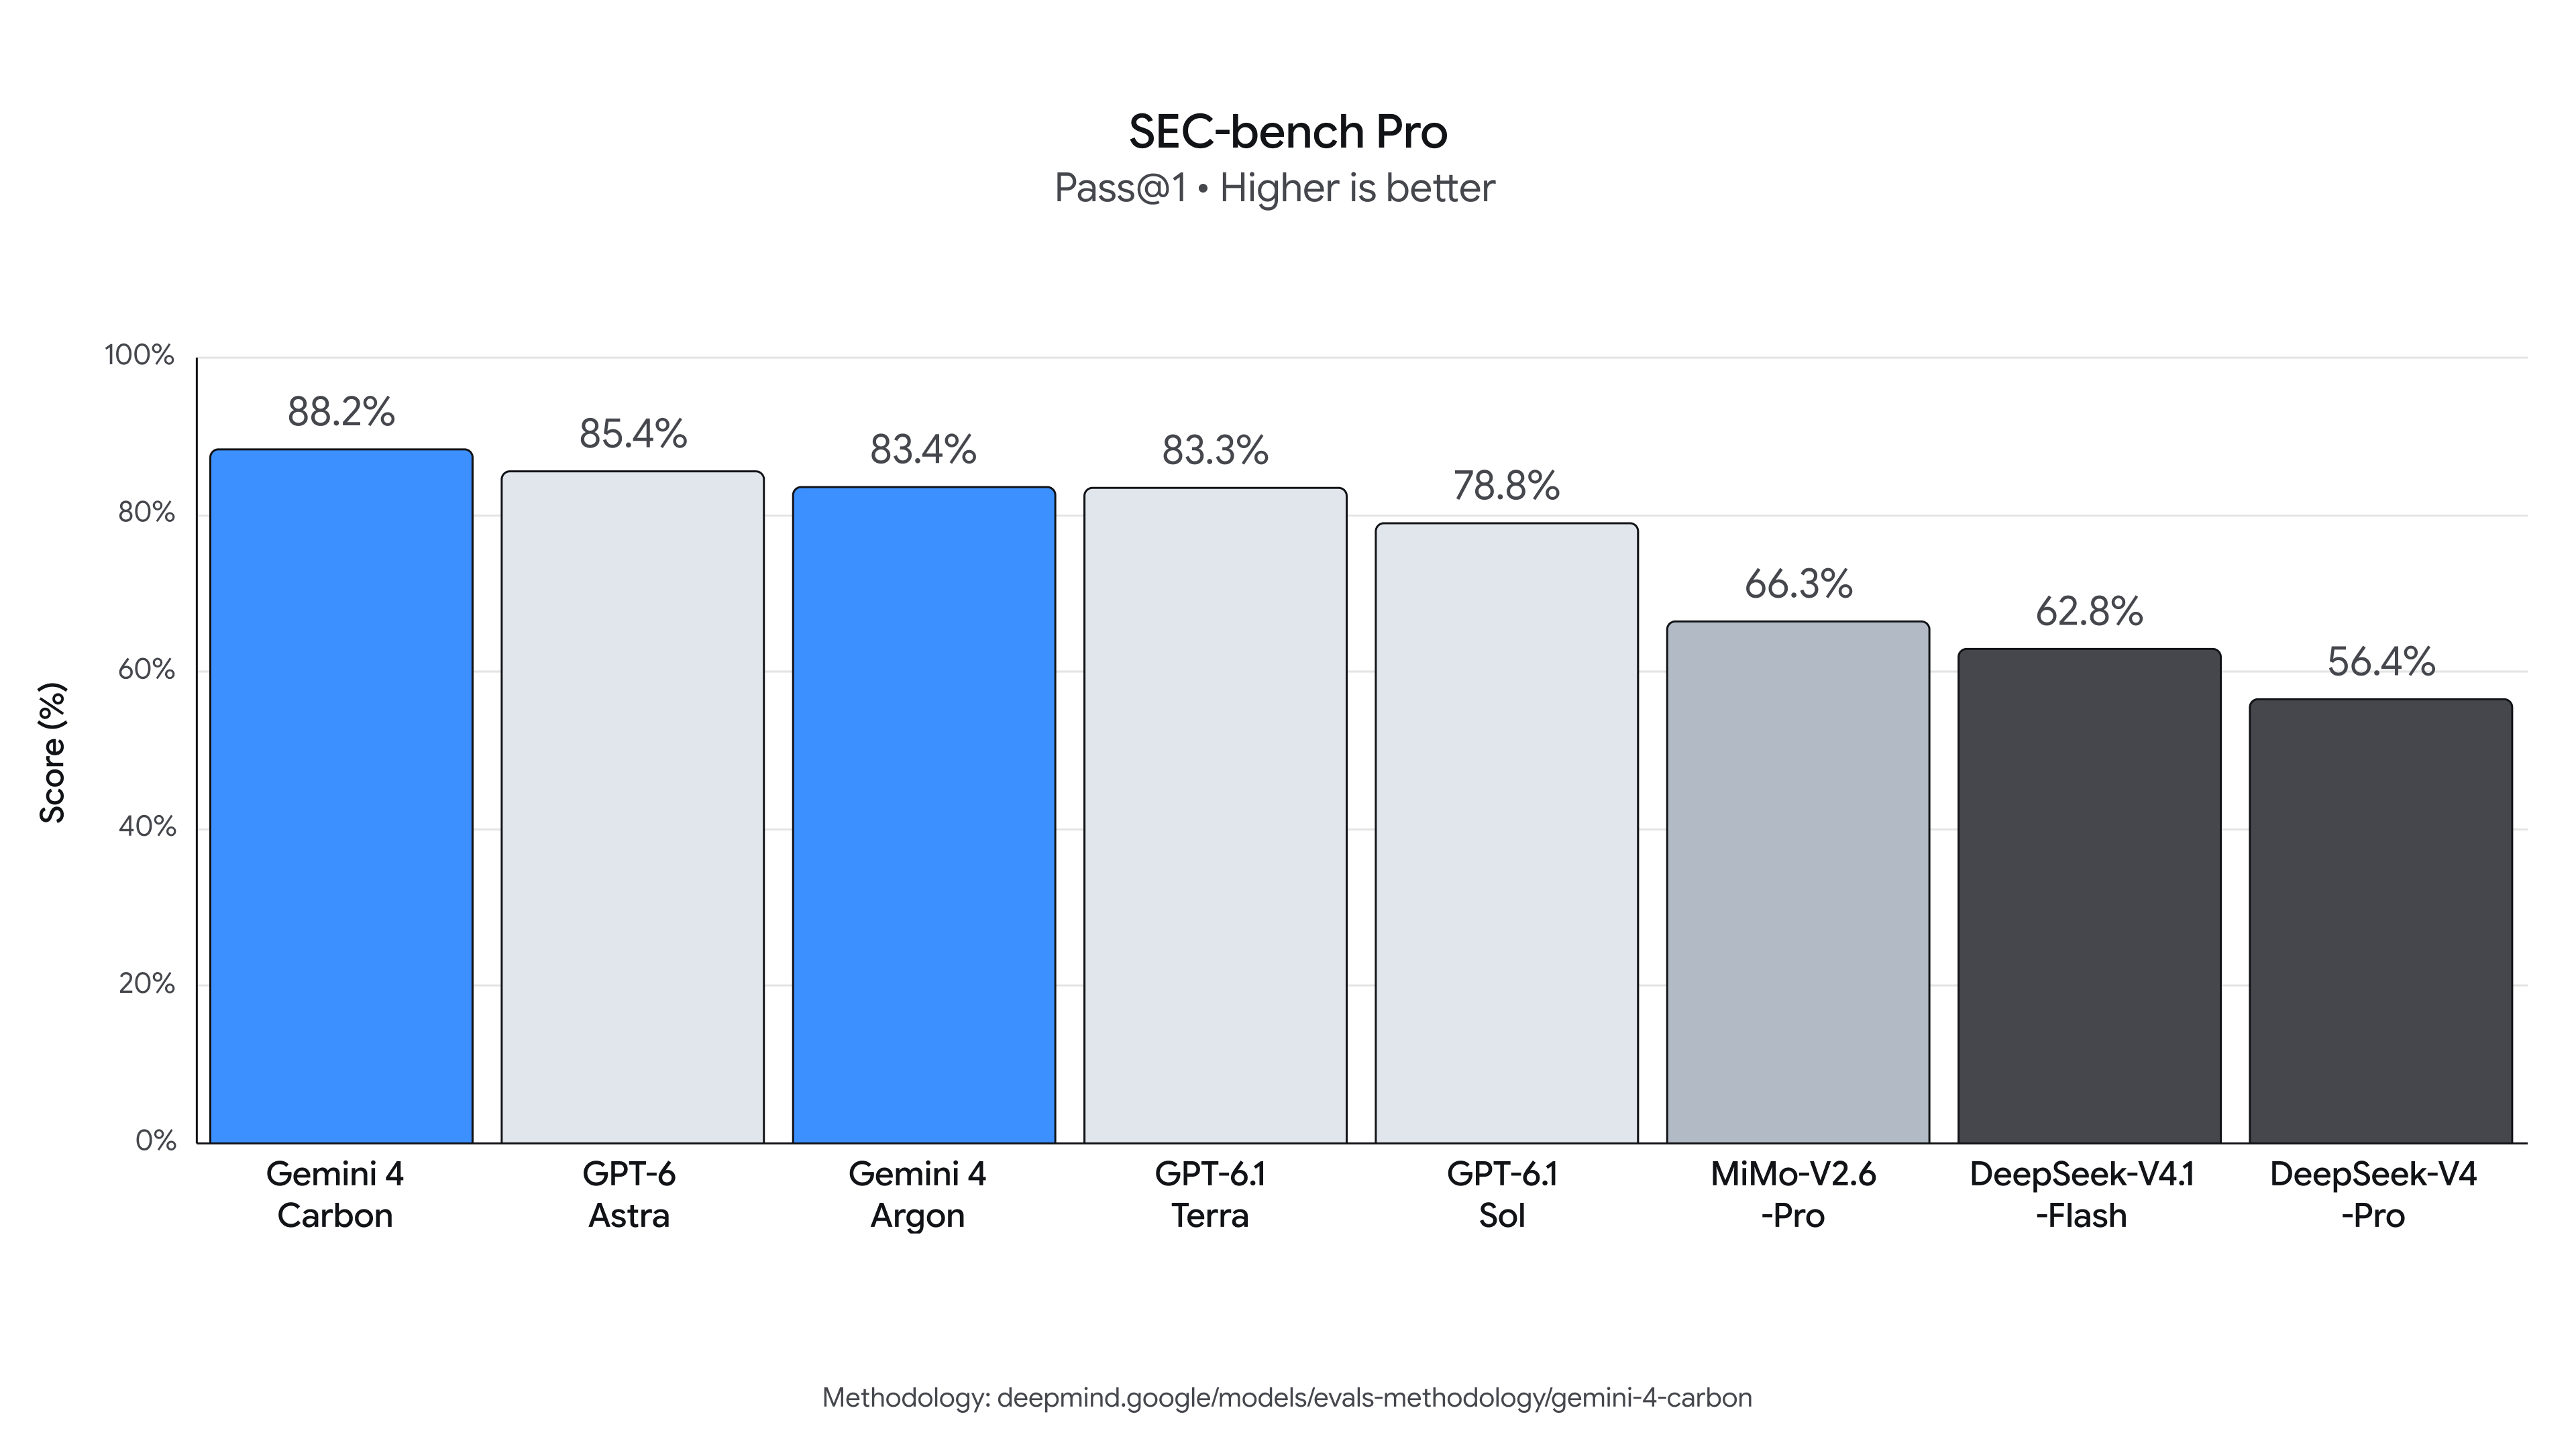
- 检测真实漏洞:网络安全的关键在于检测真实漏洞。Carbon 在 SEC-bench Pro 上取得 88.2% 的优异成绩 ,能够自主发现真实软件中隐藏的复杂缺陷。
- 通过漏洞利用验证风险:为了确定哪些漏洞应优先修复、甚至是否需要修复,网络防御者越来越多地借助模型来验证哪些漏洞可被利用。Carbon 在热门漏洞利用基准 ExploitGym 上创下新纪录(54.8%)。
- 修复根本原因:识别漏洞后,解决根本原因是网络安全生命周期中的关键一步。Carbon 在 Collinear 的 CWE-bench 平台上达到 71.0% ,可将经过验证的发现直接转化为可用的代码修复。

前沿模型安全与防护的新进展
Gemini 4 Carbon 沿用了 Argon 的多层安全架构,结合了模型训练、实时滥用防御、提示注入抵御以及思维链监控。尤其是,我们在 Argon 的模型对齐方面取得了重大进展,并在我们的安全报告中介绍了其行为一致的倾向 。借助 Carbon,我们力求在对齐方面更进一步,训练模型在面对复杂或高压任务时作出正确响应。
- 减少走捷径和钻漏洞行为:借助 Carbon,我们进一步减少了训练过程中的走捷径尝试,同时确保高质量的编程表现。Carbon 将 Terminal-Bench 4.0 上的成功作弊率降至 0.0%,作弊尝试降至 0.4%,整体准确性得到提升。在与内部团队合作的真实编程环境中,我们观察到高严重性的失准警报减少了近 80%。
- 更高的透明度与诚实性:在内部测试中,与 Argon 相比,Carbon 的无依据陈述减少了约一半。它会直接在最终产出中注明方法论上的注意事项,或在操作受阻时暂停执行并清晰列出仍需的条件,而不是编造信息或回避缺失的证据。
- 在存在歧义时更好地与用户协作:Carbon 不会猜测或强行选择路径,而是在行动前检索相关来源并向用户展示其中的差异;因此,用户在使用 Carbon 时应能获得更好的协作体验。
- 兑现承诺而不越界:Carbon 同时将过度执行减少 26%、执行不足减少 29%,从而更可靠地端到端执行多阶段计划,遵守项目限制并严格保持在范围之内。
- 抵御提示注入:此前,Argon 以 0.7% 的极低攻击成功率在 Gray Swan 间接提示注入(IPI)基准的抗注入能力上处于领先;而 Carbon 达到了 0.0%,抵御了所有被评估的攻击尝试。

即将面向开发者、企业和消费者开放
推动行业发展,既需要快速行动,也需要周密规划。借助 Gemini 4 Carbon,我们的目标是在不牺牲安全性和可靠性的前提下,在软件工程和网络安全领域取得重大进展。我们期待看到首批网络安全专业人士如何使用这一模型,并希望不久后能向开发者、企业和消费者提供 Carbon。
每周精选,直达您的邮箱
每周一:Territorio Blockchain 阅读量最高的新闻、最新一期播客以及我们活动的最新消息。免费,无垃圾邮件。
我们会发送一封确认邮件。您可以随时通过每期简报中的链接退订。 隐私政策